
[Gromacs]Cluster 聚类解析:构象聚类方法、参数指南
1. 引言
分子动力学模拟产生的轨迹往往包含成千上万帧结构,直接从中提取具有统计意义和生物学相关性的信息是一项挑战。GROMACS 提供的 gmx cluster 工具能够通过多种算法将结构按相似性分组(即聚类),从而识别出轨迹中的主要构象态。笔者基于 GROMACS 2024 官方文档,对 gmx cluster 的功能、聚类方法、输出文件及关键参数进行解读,希望帮助使用者深入理解该工具的内部机制并做出合理的选择。
2. 距离定义与相似性度量
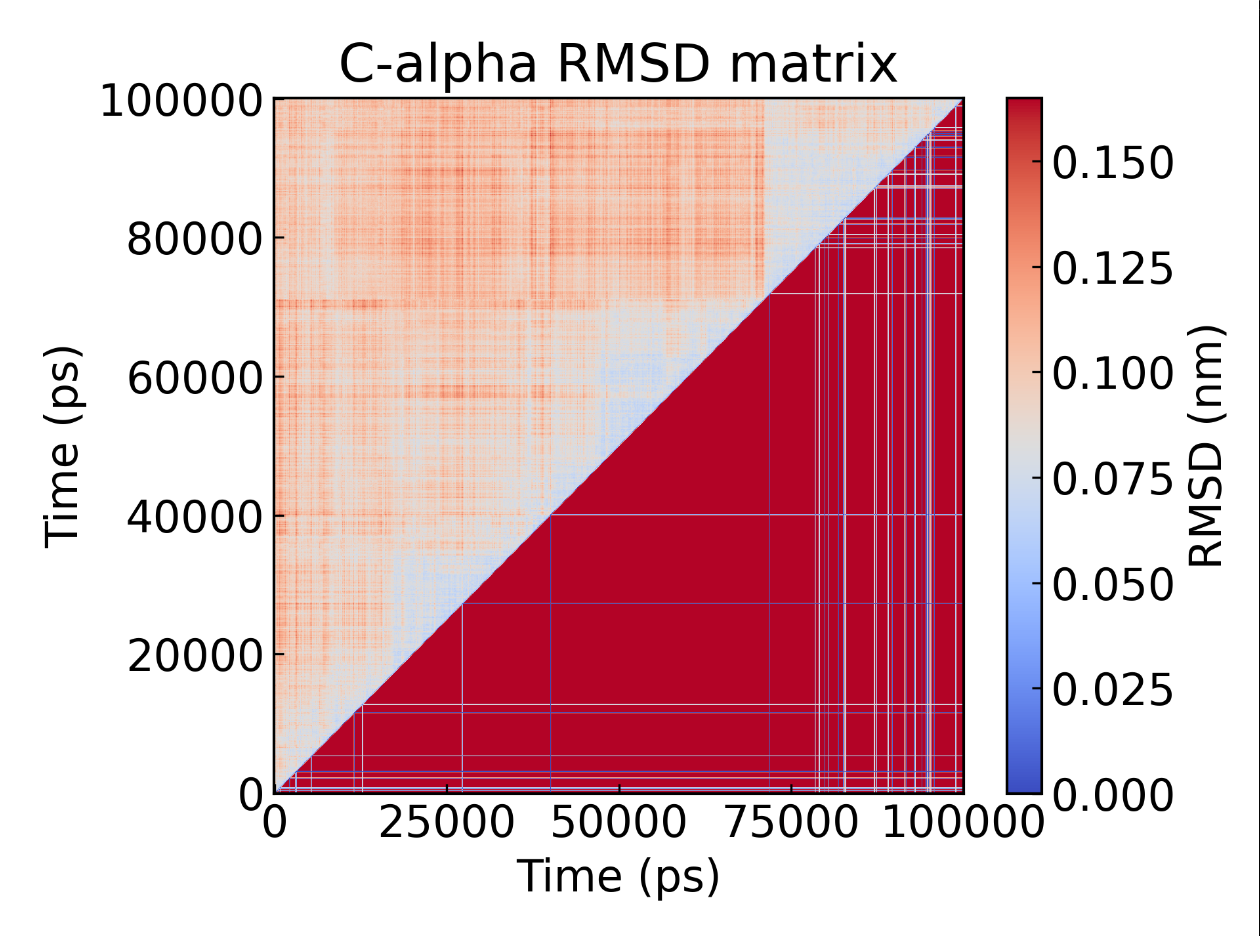
聚类的前提是定义一个能够量化两个结构之间差异的距离。在 gmx cluster 中,距离的来源有两个途径。第一种是直接从轨迹计算:读入 .xtc 或 .trr 轨迹文件,逐对计算帧间距离。默认行为是对选定的原子组进行最小二乘拟合以消除整体平动和转动,然后计算拟合后的 RMSD,这适合于评估整体构象差异。另一种方式是通过 -dista 选项计算原子对距离的 RMSD,即不进行拟合,而是直接比较两个结构中所有选定原子对之间距离的差异,该方法对结构域的刚性运动不敏感,更能反映内部几何关系的变化。第二种途径是从预计算的距离矩阵读取:利用 -dm 选项直接读入一个 .xpm 矩阵文件,该矩阵的上三角(不包括对角线)存储了结构对之间的距离。这允许用户先用外部工具生成距离矩阵,再交由 GROMACS 进行聚类。无论采用哪种方式,最终都形成一个 N×N 的距离矩阵(N 为帧数),作为聚类算法的输入。
3. 聚类方法详解
记轨迹共有 N 帧,帧编号为 1,2,\dots,N。任意两帧 i,j 之间的距离为
D_{ij}=d(\mathbf{x}_i,\mathbf{x}_j),
其中 \mathbf{x}_i 为第 i 帧所选原子组的坐标。距离矩阵
\mathbf{D}\in\mathbb{R}^{N\times N},\qquad D_{ij}=D_{ji},\qquad D_{ii}=0.
截断半径记为 \varepsilon,对应命令行中的 -cutoff,单位通常为 nm。聚类的目标就是根据 \mathbf{D} 和 \varepsilon 等参数,将 \lbrace 1,\dots,N \rbrace 划分为若干簇 \lbrace C_1,C_2,\dots \rbrace。
gmx cluster 提供了五种不同的聚类算法,通过 -method 参数指定,可选值包括 single、jarvis-patrick、monte-carlo、diagonalization 和 gromos。每种方法基于不同的原理,适用于不同的分析场景。
3.1 单链接 (single linkage)
单链接方法的原理是:若某一帧到某个簇中任意成员的距离小于截断值 -cutoff,则将该帧归入该簇。簇通过传递闭包形成——如果 A 与 B 的距离在截断值之内,B 与 C 的距离也在截断值之内,则 A、B、C 同属一簇,即便 A 与 C 的直接距离可能大于截断值。
数学表述:
构造无向图 G=(V,E),其中
V=\lbrace 1,2,\dots,N \rbrace,\qquad E=\lbrace (i,j)\mid i\ne j,\ D_{ij}\le \varepsilon \rbrace.
单链接聚类的结果就是该图的连通分量。等价地,定义关系
i\sim j \iff \exists\, i=v_0,v_1,\dots,v_k=j,\quad D_{v_{m-1},v_m}\le \varepsilon\ (m=1,\dots,k).
若 i\sim j,则 i,j 属于同一簇。
从簇间距离的更新角度看,单链接采用最小距离准则:
d(C_a,C_b)=\min_{i\in C_a,\ j\in C_b} D_{ij}.
若存在 j\in C 使得 D_{ij}\le \varepsilon,则帧 i 被并入簇 C。
这种方法能发现任意形状的簇,对于构象空间连续、过渡态丰富的轨迹(如蛋白质折叠早期的塌缩过程)具有良好的适应性。但其明显的缺点是容易产生“链式效应”:
D_{ij}\le \varepsilon,\quad D_{jk}\le \varepsilon,\quad \text{但 } D_{ik}>\varepsilon,
此时 i,j,k 仍会被归入同一簇,导致一个簇过度膨胀,将一系列构象差异其实不小的结构串联进同一簇,从而降低分辨率。
3.2 Jarvis Patrick 方法
Jarvis Patrick 方法基于共享邻居的概念。首先为每一帧确定其邻居:邻居可以是距离最近的 M 个结构(由 -M 指定),也可以是在 -cutoff 范围内的所有结构。然后,只有当两帧互为邻居并且至少共享 P 个共同邻居(-P 参数)时,它们才被归入同一簇。
数学表述:
对每一帧 i,定义其邻居集合 N_i。
若采用“最近的 M 个邻居”:
N_i=\lbrace j\mid j\ne i,\ \operatorname{rank}_i(j)\le M \rbrace,
其中 \operatorname{rank}_i(j) 是 D_{ij} 在第 i 行中按升序排列的排名。
若采用“截断半径内的邻居”:
N_i=\lbrace j\mid j\ne i,\ D_{ij}\le \varepsilon \rbrace.
定义邻接指示量
A_{ij}= \begin{cases} 1,& j\in N_i,\ 0,& j\notin N_i. \end{cases}
两帧 i,j 互为邻居的条件为
A_{ij}=1 \quad\text{且}\quad A_{ji}=1.
两帧共享邻居数为
s_{ij}=|N_i\cap N_j|=\sum_{k=1}^{N} A_{ik}A_{jk}.
Jarvis Patrick 的同簇判据为
A_{ij}A_{ji}=1 \quad\text{且}\quad s_{ij}\ge P.
满足该条件的帧对构成图中的边,最终簇为该图的连通分量。
这一额外约束比单链接更加严格,能够有效抑制链式效应,生成更紧凑、大小相对均匀的簇。然而,该方法的性能对参数 M 和 P 较为敏感,需要仔细调参,适用于希望避免极端离群结构且要求簇内同质性较高的情形。
3.3 Monte Carlo 方法
Monte Carlo 方法并非传统意义上的聚类,而是对距离矩阵进行重排序,使得相邻帧之间的构象差异尽可能小,从而构造出一条平滑的构象变化路径。它通过蒙特卡罗优化寻找一个帧排列,最小化相邻帧距离增量的总和。输出结果反映在 -o 矩阵图中,不会生成离散的簇标签。
数学表述:
设 \pi=(\pi_1,\pi_2,\dots,\pi_N) 是 \lbrace 1,2,\dots,N \rbrace 的一个排列。重排后相邻帧之间的距离为
d_k(\pi)=D_{\pi_k,\pi_{k+1}},\qquad k=1,2,\dots,N-1.
若以“相邻帧距离增量的平滑性”为目标,可定义能量函数
E(\pi)=\sum_{k=1}^{N-2}\left|d_{k+1}(\pi)-d_k(\pi)\right|.
另一种常见理解是直接最小化相邻帧距离之和:
E(\pi)=\sum_{k=1}^{N-1} d_k(\pi)=\sum_{k=1}^{N-1}D_{\pi_k,\pi_{k+1}}.
优化过程可采用 Metropolis 准则:从当前排列 \pi 随机交换两帧得到 \pi',计算
\Delta E=E(\pi')-E(\pi),
接受概率为
P_{\text{accept}}=\min\left(1,\exp\left(-\frac{\Delta E}{kT}\right)\right),
其中 kT 为控制退火过程的温度参数。最终得到一个使相邻帧距离变化尽量平滑的帧排列。
这种方法特别适合可视化平均力势(PMF)集合的构象连续变化,或者拉伸分子动力学中渐进过渡的构象序列。需要注意的是,输入轨迹不应进行过帧间叠加处理,否则距离矩阵可能掩盖真实的变化趋势。
3.4 对角化方法 (diagonalization)
对角化方法通过对距离矩阵进行特征分解,提取主要特征向量。它在理念上与主成分分析(PCA)类似,但分解的对象是距离矩阵而非协方差矩阵。用户可通过 -ev 选项输出特征向量,用于在低维空间中对构象进行投影。
数学表述:
距离矩阵 \mathbf{D} 为实对称矩阵,可特征分解为
\mathbf{D}\mathbf{v}_k=\lambda_k\mathbf{v}_k,\qquad \mathbf{D}=\mathbf{V}\boldsymbol{\Lambda}\mathbf{V}^{\mathsf T},
其中
\boldsymbol{\Lambda}=\operatorname{diag}(\lambda_1,\lambda_2,\dots,\lambda_N),\qquad \mathbf{V}=[\mathbf{v}_1,\mathbf{v}_2,\dots,\mathbf{v}_N].
将特征值按绝对值或大小排序:
|\lambda_1|\ge |\lambda_2|\ge\cdots\ge|\lambda_N|.
取前 m 个特征向量构成投影矩阵
\mathbf{V}_m=[\mathbf{v}_1,\mathbf{v}_2,\dots,\mathbf{v}_m].
第 i 帧在低维空间中的坐标为
\mathbf{z}_i=\mathbf{V}_m^{\mathsf T}\mathbf{e}_i = \bigl(v_{1,i},v_{2,i},\dots,v_{m,i}\bigr)^{\mathsf T}.
若采用经典多维标度(MDS)形式,可先对平方距离矩阵做双中心化:
\mathbf{B}=-\frac12\mathbf{J}\mathbf{D}^{(2)}\mathbf{J},\qquad \mathbf{J}=\mathbf{I}-\frac1N\mathbf{1}\mathbf{1}^{\mathsf T},\qquad D^{(2)}_{ij}=D_{ij}^2.
再对 \mathbf{B} 特征分解:
\mathbf{B}=\mathbf{U}\boldsymbol{\Lambda}\mathbf{U}^{\mathsf T},
低维坐标为
\mathbf{X}_m=\mathbf{U}_m\boldsymbol{\Lambda}_m^{1/2}.
累计贡献率可写为
R_m=\frac{\sum_{k=1}^{m}\lambda_k}{\sum_{k=1}^{N}\lambda_k}.
这一方法的主要用途是数据降维和可视化,而非硬性划分簇。它本身不直接提供簇分配结果,但可以与其他聚类工具相结合,或用于评估构象空间的本质维度。由于需要对角化大型矩阵,计算代价较高,适用于需要揭示连续构象变化的核心维度的深入分析。
3.5 Gromos 方法
Gromos 方法基于 Daura 等人 (1999) 提出的算法,是目前蛋白质 MD 轨迹聚类中应用最广泛的方法。
数学表述:
设当前尚未分配的结构集合为 R\subseteq\lbrace 1,\dots,N \rbrace。对每个 i\in R,定义其在 R 中的邻居集合与邻居数:
N_i(R)=\lbrace j\in R\mid j\ne i,\ D_{ij}\le \varepsilon \rbrace,\qquad n_i(R)=|N_i(R)|.
算法迭代如下:
- 在剩余集合 R 中选取邻居数最多的帧作为新簇中心:
c_k=\arg\max_{i\in R} n_i(R). - 形成第 k 个簇:
C_k=\lbrace c_k \rbrace\cup N_{c_k}(R). - 从剩余集合中移除该簇:
R\leftarrow R\setminus C_k. - 重复上述过程,直到 R=\varnothing。
最终得到簇划分
\lbrace C_1,C_2,\dots,C_K \rbrace,\qquad \bigcup_{k=1}^{K}C_k=\lbrace 1,\dots,N \rbrace,\qquad C_a\cap C_b=\varnothing\ (a\ne b).
每个簇的中心 c_k 是真实存在的轨迹帧,而不是算术平均结构。簇内平均 RMSD 可定义为成员到中心的平均距离:
\bar r_k=\frac{1}{|C_k|}\sum_{i\in C_k}D_{i,c_k},
或成员两两之间的平均距离:
\bar r_k=\frac{2}{|C_k|(|C_k|-1)} \sum_{\substack{i,j\in C_k\ i<j}}D_{ij}.
日志文件中的 avgrmsd 通常用于反映簇内构象的紧密程度。
其步骤可概括为:首先统计每个结构在截断半径 -cutoff 内的邻居数量;然后选取邻居数最多的结构作为第一个簇的中心,将该中心及其所有邻居从数据池中移除,形成一个簇;接着在剩余结构中重复这一过程,直至所有结构都被分配完毕。簇的中心是真实存在的轨迹帧(邻居数最多的那一帧),而非算术平均结构。簇的形状可视为以中心为球心、cutoff 为半径的超球体。该方法计算速度快,结果直观,且可通过 -max 限制最大簇数目,或通过 -skip 跳过某些簇。其簇中心为真实构象的特性使得后续的结构解析和生物学解释更为直接,因此推荐作为常规 MD 轨迹聚类的首选。
各聚类方法对比
| 方法 | 是否硬聚类 | 中心性质 | 数学判据/目标 | 关键参数 | 计算速度 | 适用场景 | ||
|---|---|---|---|---|---|---|---|---|
| single linkage | 是 | 无明确中心 | 图 G 的连通分量,边满足 D_{ij}\le\varepsilon | -cutoff |
较快 | 构象空间连通性分析 | ||
| Jarvis Patrick | 是 | 无明确中心 | A_{ij}A_{ji}=1 且 s_{ij}\ge P | -cutoff, -M, -P |
中等 | 要求均匀簇、抑制链式效应 | ||
| Monte Carlo | 否(重排序) | 无 | 最小化 E(\pi)=\sum</td> <td>d_{k+1}-d_k</td> <td> 或 \sum d_k |
无 | 慢 | 路径可视化,PMF 展示 | ||
| diagonalization | 否(降维) | 无 | \mathbf{D}\mathbf{v}_k=\lambda_k\mathbf{v}_k 或 MDS 特征分解 | 无 | 慢 | 特征提取,本质维度分析 | ||
| gromos | 是 | 真实帧 | c_k=\arg\max_{i\in R} n_i(R),C_k=\lbrace c_k \rbrace\cup N_{c_k}(R) | -cutoff(可配合 -max) |
快 | 常规 MD 轨迹构象聚类(推荐) |
4. 关键参数详解
参数可分为轨迹输入、方法控制、簇输出以及蒙特卡罗特有等几类。
在轨迹输入与预处理方面,-f 指定输入轨迹,-s 提供参考结构用于拟合和质量加权,-n 指定索引文件,用于选择参与聚类和拟合的原子组(拟合组与计算组应一致,常选 Backbone 或 C-alpha)。通过 -b、-e 和 -dt 可以限定分析的时间段和采样间隔,对于长轨迹,必须用 -dt 进行稀疏采样以降低距离矩阵的计算量和内存消耗,一般将帧数控制在 2000–5000 以内较为稳妥。-[no]fit 控制是否进行最小二乘拟合,默认为开启;当使用 -dista 模式时则应关闭拟合。-[no]dista 选项则直接切换至原子对距离差异的 RMSD 计算,适合忽略整体平移旋转的场合。
方法控制参数中,-method 选择聚类算法,-cutoff 设置截断距离(单位 nm),这是单链接、Jarvis Patrick 和 gromos 方法的核心参数,决定了簇的最大半径。对于 Jarvis Patrick 方法,-M 和 -P 分别控制邻居数量和共享邻居数。对于 gromos 方法,-max 可限制最大簇数目,-skip 可跳过前若干个簇,-nlevels 则设置矩阵图中的颜色等级数。
簇输出相关参数中,-minstruct 定义了一个簇有效的最小成员数,低于该值的簇将被忽略。-av 请求输出平均结构而非中心结构。-wcl 与 -nst 和 -rmsmin 配合,可选择性导出簇成员轨迹。
Monte Carlo 方法的特有参数如 -seed、-niter、-nrandom 和 -kT 等控制模拟退火过程,一般使用默认值即可。
通用选项方面,-[no]pbc 可开关周期性边界条件处理,若轨迹已经过 trjconv -pbc mol 处理,建议设为 -nopbc;-tu 设置时间单位;-xvg 控制 xvg 输出格式。
5. 实际应用策略与工作流
典型的聚类分析流程包括轨迹准备、原子组提取、方法与参数选择、运行与评估、代表性结构提取以及动力学分析等步骤。轨迹必须预先经过周期性边界条件处理和整体运动的去除(如 trjconv -pbc mol -fit rot+trans)。接着提取关注的原子组(通常为 Cα 或主链),然后选择聚类方法。
对于绝大多数蛋白质体系,推荐从 gromos 方法入手,初步 cutoff 可设为 0.1 nm。运行后可借助 -dist 输出的 RMSD 分布图以及 -g 日志中的簇大小分布来优化 cutoff:理想的 cutoff 应使第一个簇占比不超过 50%,且总簇数适中(例如 5–20)。确定参数后重新运行并提取 -cl 的中心结构用于可视化或后续计算。利用 -clid、-tr 等输出可以研究构象态的动力学行为和转变网络,为进一步建立 Markov 状态模型奠定基础。
当处理大型轨迹时,建议通过 -dt 降低采样帧数;对于蛋白质-配体复合物,可以仅对蛋白质部分聚类,再通过 -clndx 提取相应帧的完整体系坐标。
详细操作Gromacs轨迹聚类:
6. 结语
gmx cluster 作为 GROMACS 中功能丰富的构象分析模块,集成了多种聚类算法和详尽的输出选项,能够满足从简单构象分群到复杂动力学网络构建的不同层次需求。深入理解各方法的原理、参数含义及输出内容,有助于从大量模拟数据中挖掘出具有生物学意义的构象信息,为后续研究提供坚实支撑。

